Gender Bias in Chinese, Portuguese, and English Machine Translation
Compreenda a organização dos datasets, scripts, modelos e traduções no repositório de código da tese.
By J
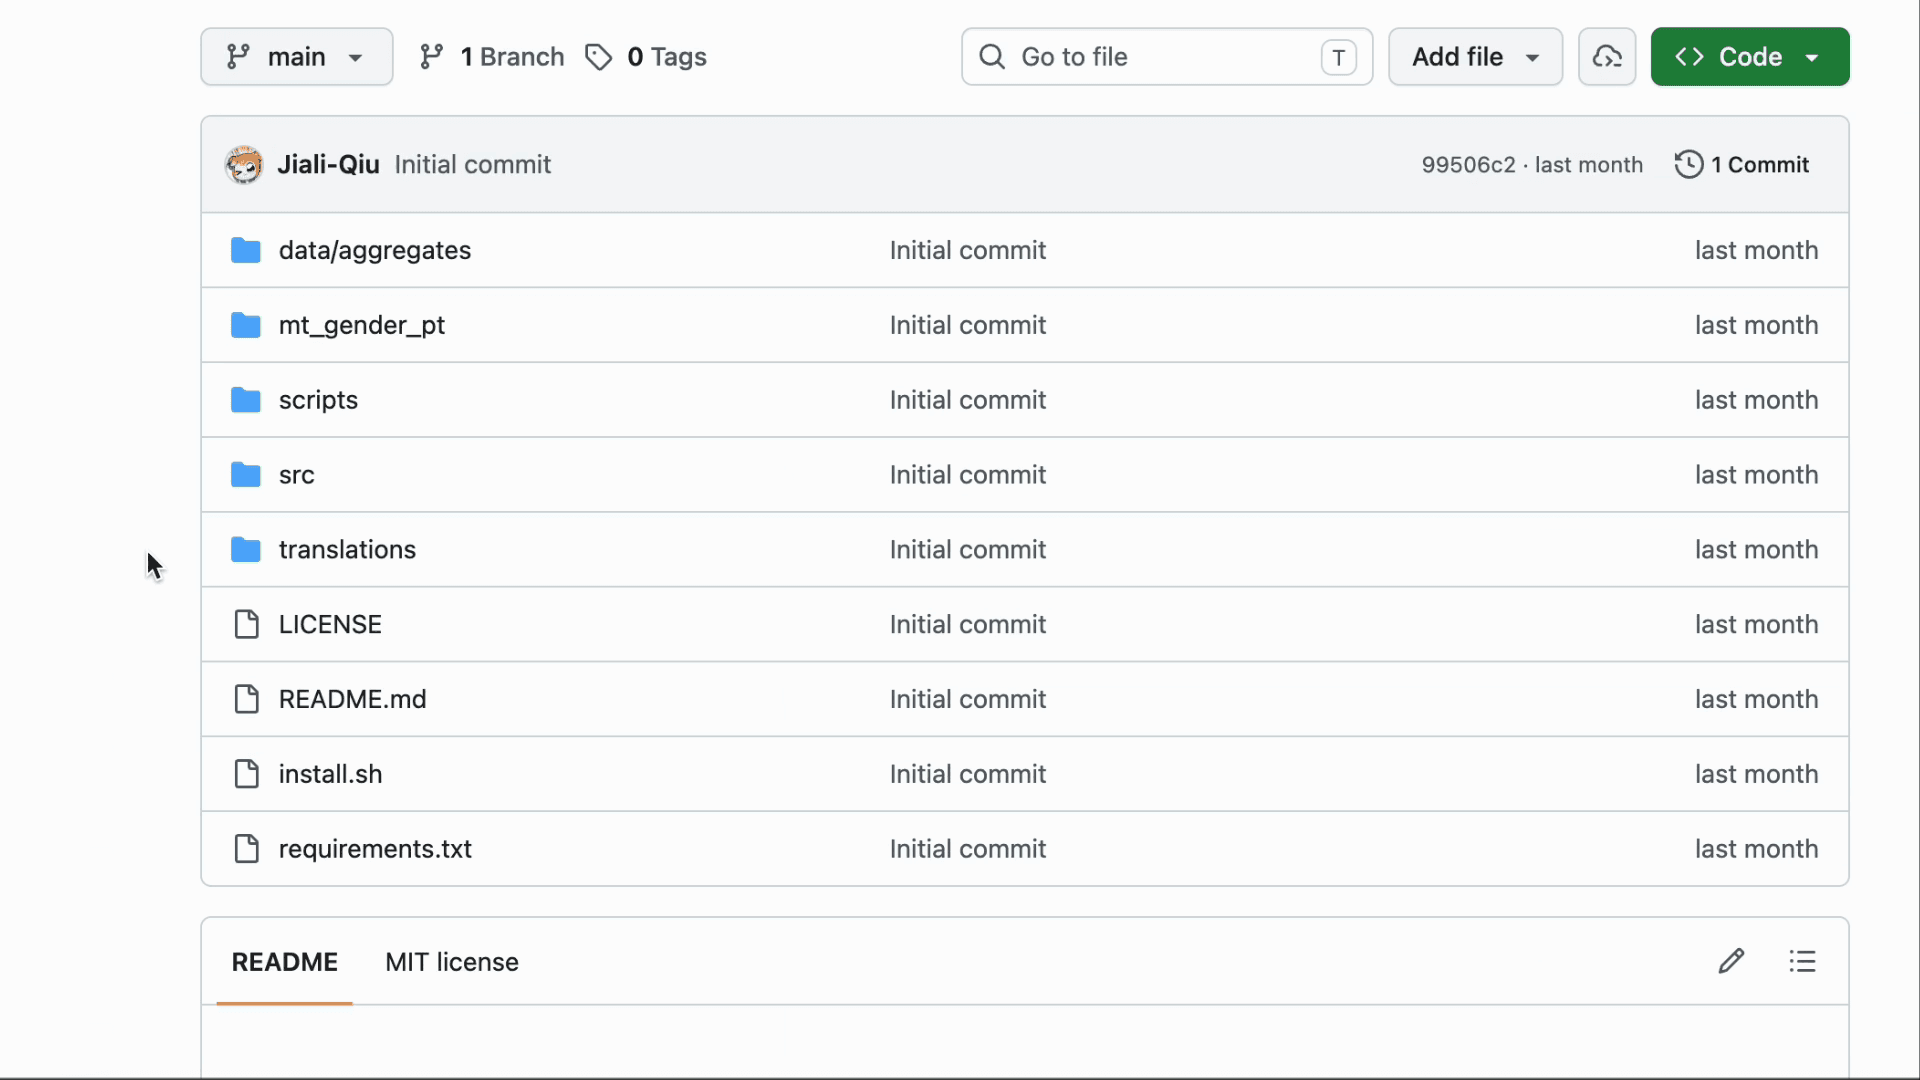
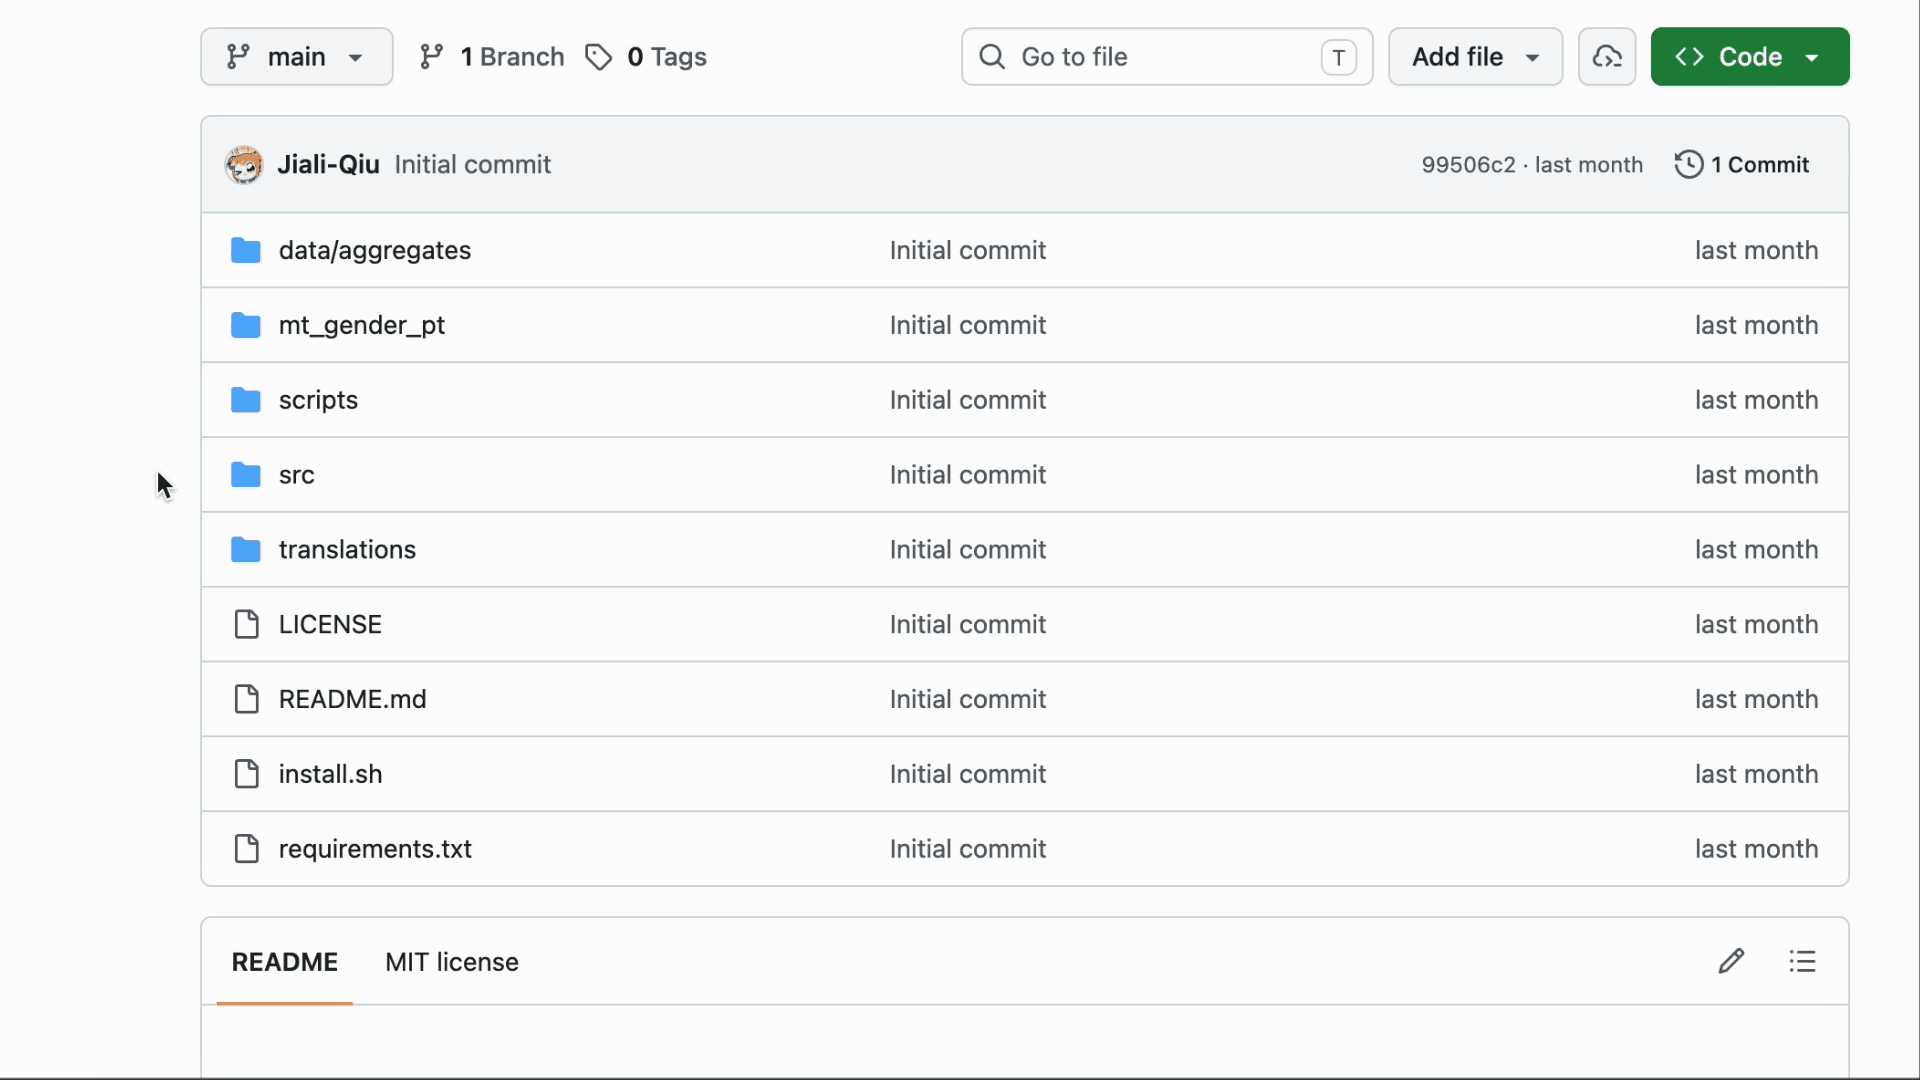
Este guia apresenta a organização estrutural do repositório da tese, permitindo localizar rapidamente conjuntos de dados, modelos, scripts de avaliação e traduções.
Aplica-se a investigadores, estudantes e avaliadores que pretendam explorar, reproduzir ou auditar o código e os dados das experiências realizadas.
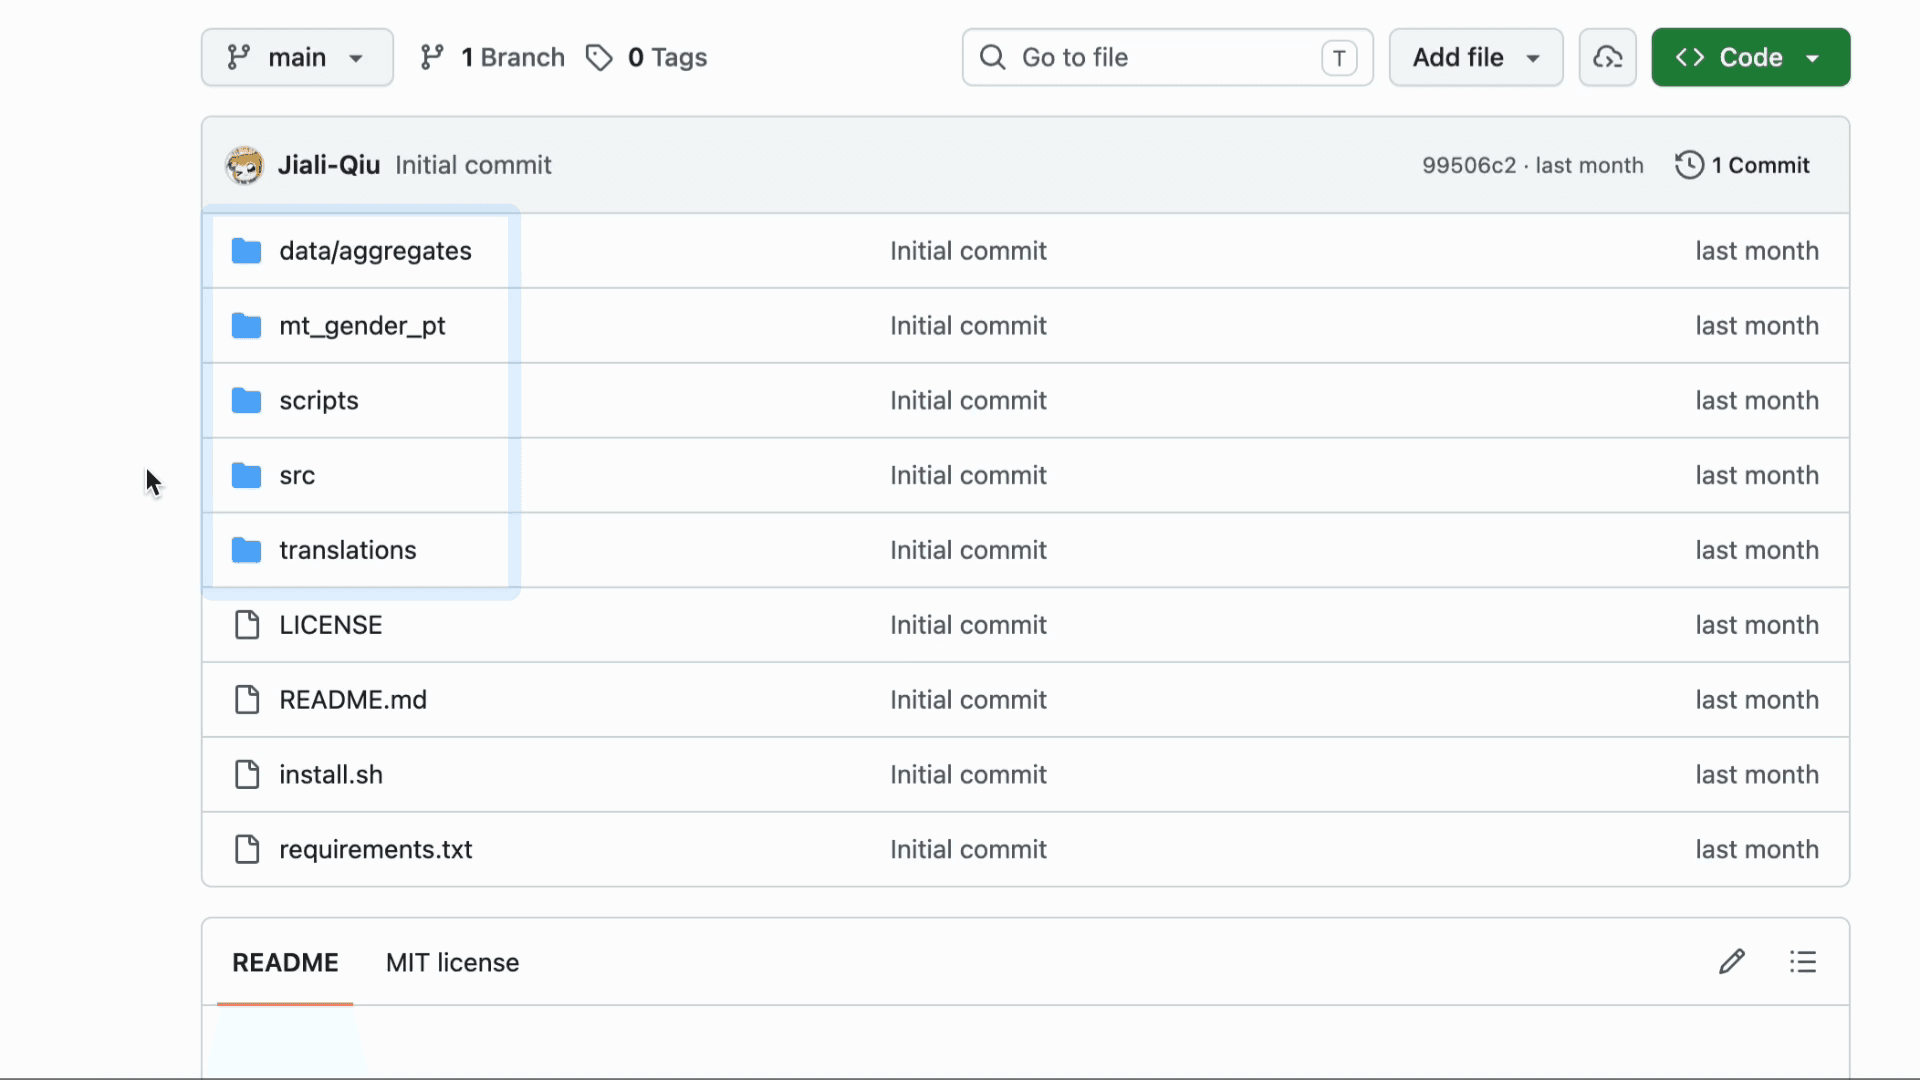
O projeto encontra-se modularizado em diretórios principais para separar dados de entrada, código-fonte, scripts de análise e recursos traduzidos.
Localização de Dados e Datasets
Para aceder aos conjuntos de dados experimentais:
1
Clique na pasta data/aggregates para consultar o dataset WinoQiu e as suas variantes.
2
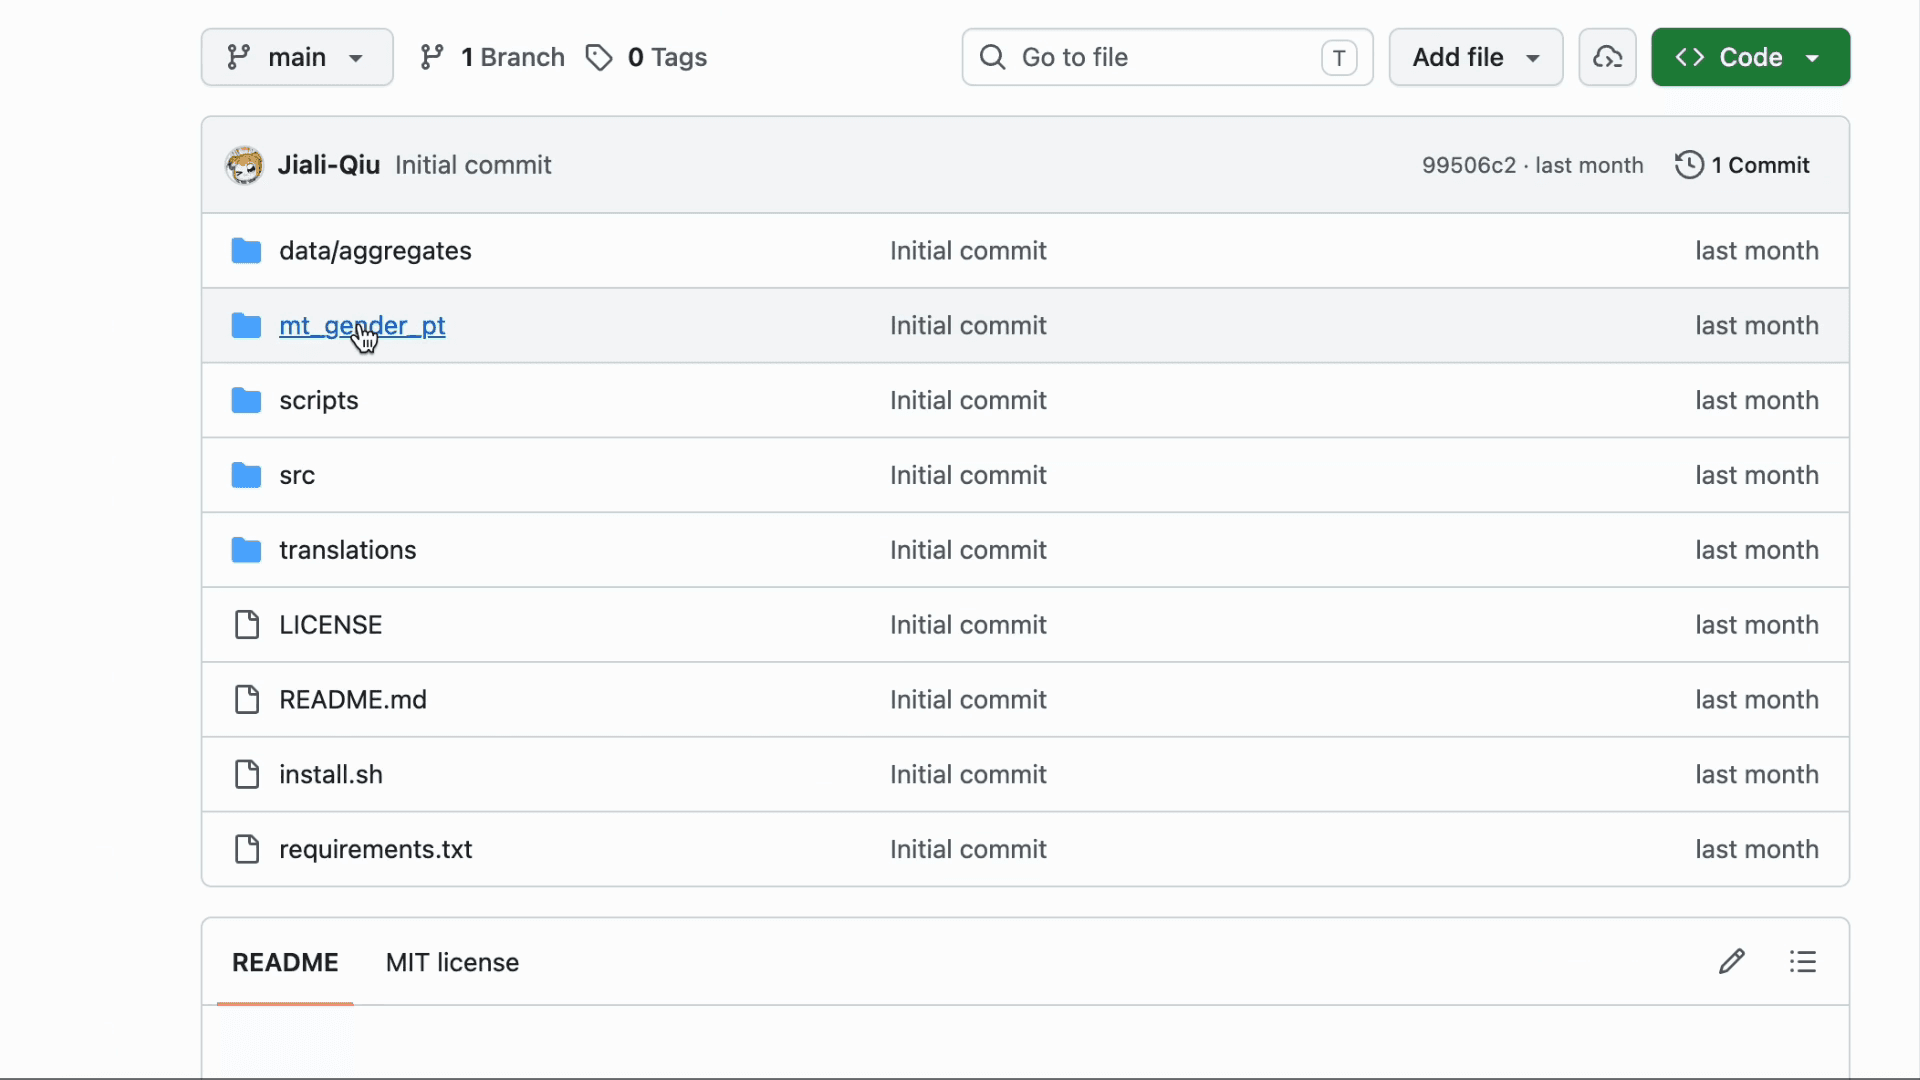
Clique na pasta mt_gender_pt para aceder aos dados e códigos de comparação com o trabalho anterior.
Código-fonte e Avaliação
Os ficheiros de execução, modelos e processamento estão divididos conforme a sua finalidade:
3
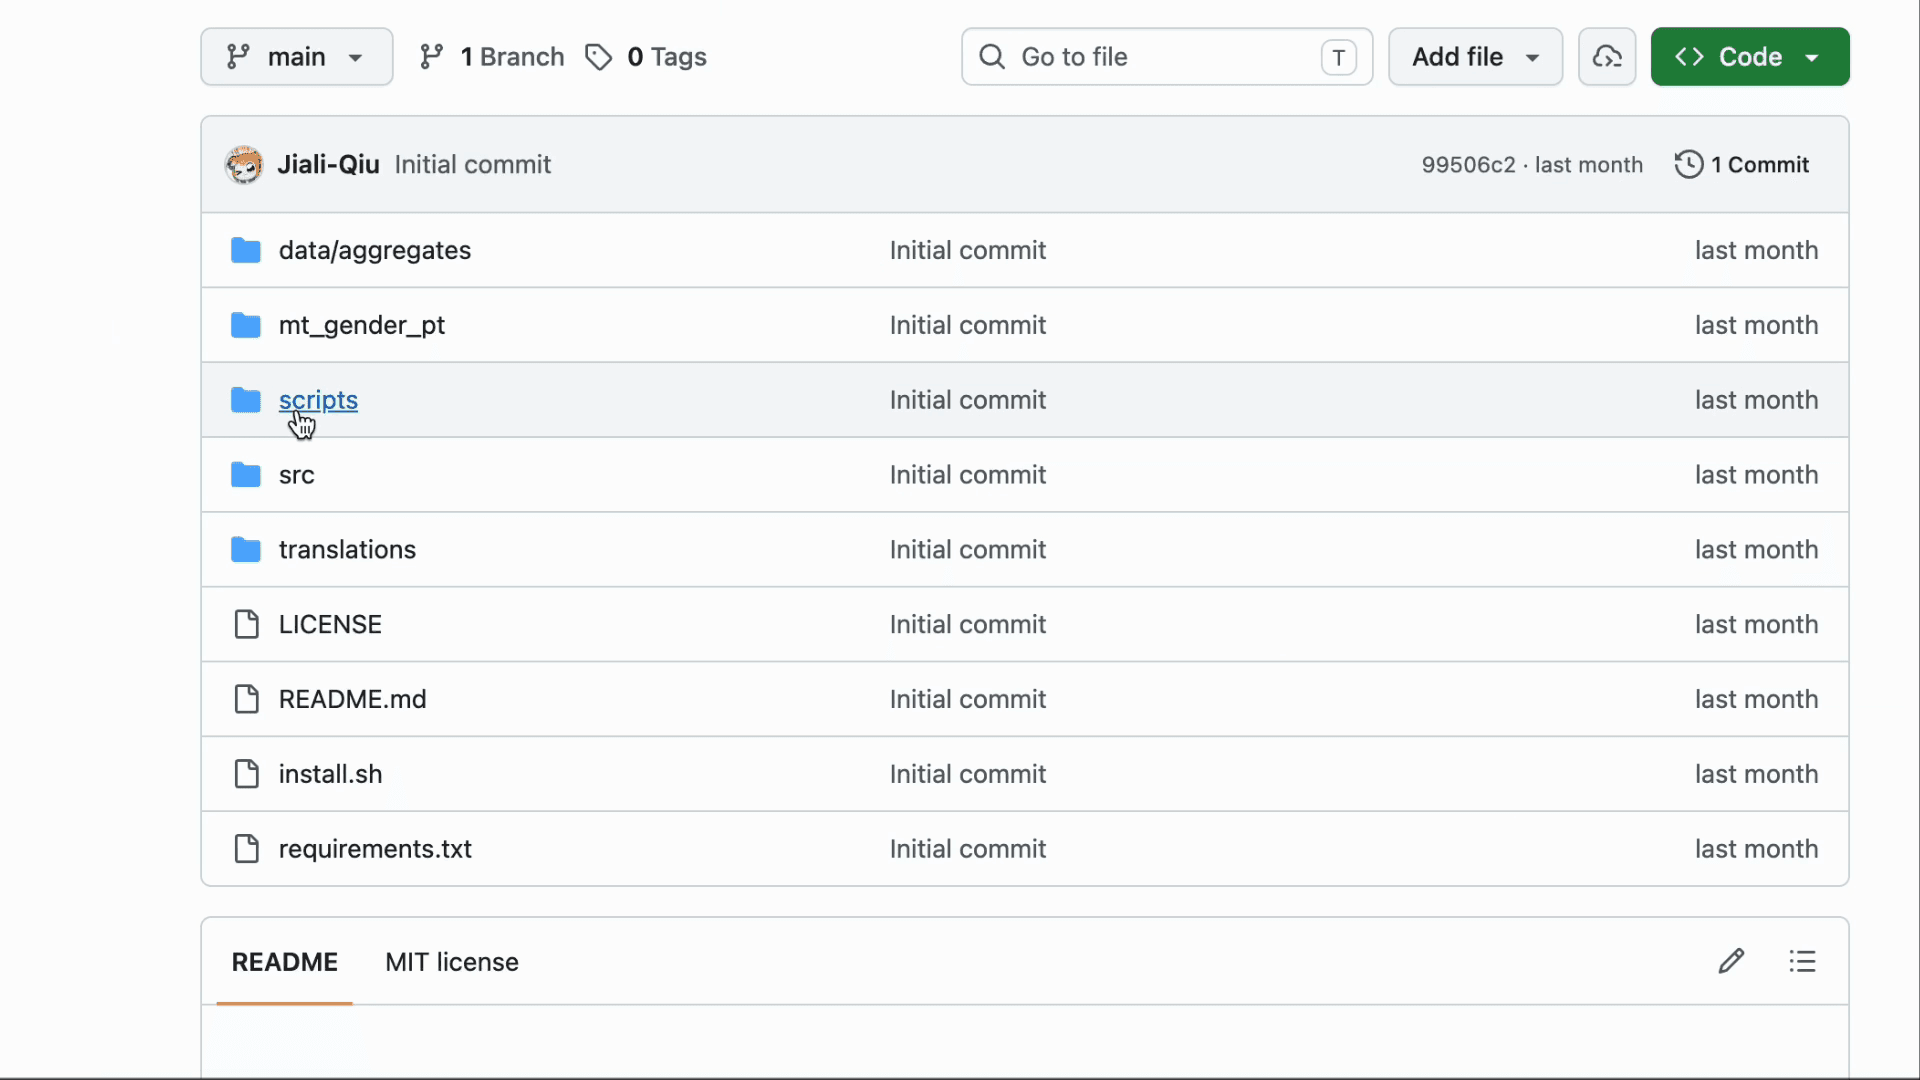
Clique na pasta scripts para aceder aos códigos de avaliação dos resultados.
4
Clique na pasta src para consultar o código-fonte dos modelos e do pré-processamento.
Recursos de Tradução
5
Clique na pasta translations para visualizar as traduções utilizadas nas experiências.